来源:papers/iVc/DCVC_讲解资源/来源/聊天讲解02_Figure1与贡献.md · 原始 Markdown
继续读 :codex-file-citation{path="E:/Projects/papers/iVc/Li_Deep_Contextual_Video_Compression_NeurIPS_2021_paper.pdf" purpose="source"} 第 2 页:Figure 1、引言第 3—4 段,以及四项贡献。本轮读完 Introduction。
这一页要抓住的核心是:上下文同时参与表示、重建和概率估计,三个位置的作用各不相同。
一、Figure 1:先看信息怎样流动
下面是论文原图的裁切:
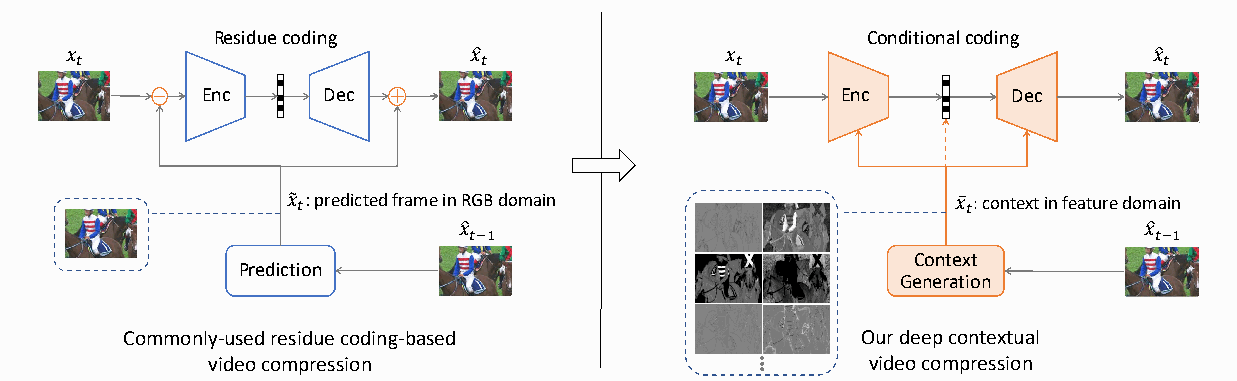
先区分四个符号:
| 符号 | 含义 |
|---|---|
| x_t | 当前原始帧 |
| \hat{x}_{t-1} | 上一重建帧,编码端和解码端都可以获得 |
| \tilde{x}_t | RGB 域预测帧 |
| \bar{x}_t | 特征域上下文 |
左侧:先相减,再编码残差。
从下往上看:
- 上一重建帧经过 Prediction,生成预测帧 \tilde{x}_t。
- 当前帧与预测帧相减,得到残差。
- Enc 编码残差,Dec 恢复重建残差。
- 将重建残差与预测帧相加,得到 \hat{x}_t。
图中的两个橙色圆圈,明确规定了图像域的“减”和“加”。
右侧:让参考信息以特征形式参与编码与重建。
参考信息经过 Context Generation,生成上下文 \bar{x}_t,随后分成三路:
- 送入 Enc,帮助形成当前帧的表示。
- 送入 Dec,帮助重建当前帧。
- 沿橙色虚线参与熵建模,帮助估计编码符号的概率。
右侧没有预先规定必须先做 RGB 域相减、最后再相加。网络获得了更灵活的条件输入,可以学习怎样组合当前内容与参考信息。
蓝色虚线框展示的是预测图或特征图的样貌。右侧几张灰度图只是特征示意,不能据此判断实际通道数,也不能给每个通道指定固定语义。
这张图展示了框架差异;实际码率、画质和速度,仍需要实验验证。
二、引言第 3 段:条件是什么,怎样使用,怎样学习?
英文短摘录:
“What is condition?”
翻译:“什么是条件?”
段落释义: 作者将条件定义为可学习的特征上下文,供编码器、解码器和熵模型共同使用,并以运动估计与补偿引导上下文生成。本段还报告了与 x265 veryslow、DVCPro 的码率比较结果。
先把三个问题分别讲清楚。
1. 条件是什么?
一张预测图可以作为条件,但条件也可以是一份多通道特征。
例如,网络可以将参考图像转换为便于处理边缘、纹理等结构的表示。这里不要求每个通道都具有明确的人类语义。
作者说条件维度可以灵活设计,意思是表示形式、通道数等可以由模型选择。增加通道并没有凭空创造当前帧的真实信息;它可能让网络更容易利用已有信息。 通道更多是否值得,要结合压缩收益与计算成本判断。
2. 条件为什么要送到三个位置?
下面是教学用简化式,省略了论文实际模型的其他先验和支路:
c_t:=\bar{x}_t, \qquad y_t=E_\theta(x_t,c_t),
\hat y_t=Q(y_t), \qquad \hat x_t=D_\phi(\hat y_t,c_t).
其中 E 是编码变换,D 是解码变换,Q 是量化,\hat y_t 是量化后的潜在表示。
| 使用位置 | 它回答的问题 |
|---|---|
| 编码器 | 已有参考信息后,当前帧还需要怎样表示? |
| 解码器 | 如何结合码流与参考信息恢复当前内容? |
| 熵模型 | 当前条件下,各个量化符号出现的概率是多少? |
前两项影响表示与重建方式,第三项影响这些表示需要多少比特。
理解熵模型,可以联系理想码长:
\ell(\hat y_t,c_t) \approx-\log_2 p_\psi(\hat y_t\mid c_t,\ldots).
概率模型认为某个实际出现的符号越可能,其理想码长就越短。
【补充示例】若上下文使某个实际出现符号的模型概率从 1/8 提高到 1/2,对应的信息量就从 3 bit 变为 1 bit。不过,总体收益取决于全部符号的平均负对数概率,不能只看单个符号。
这也解释了论文为什么强调橙色虚线:条件不仅帮助网络生成表示,还帮助概率模型压缩这些表示。
文中“熵模型随时间自适应”,在这里表示条件随视频内容变化,预测的概率分布相应变化;不能直接理解成网络权重必须逐帧在线更新。
3. 条件怎样学习?为什么需要运动?
作者使用运动估计与运动补偿,即 MEMC,帮助寻找相关的参考特征。
【补充示例】假设一辆车向右移动了 5 个像素。当前车门位置对应的参考内容,可能位于上一帧左侧 5 个像素附近。直接取上一帧同坐标的特征,可能取到其他部位甚至背景;运动对齐则帮助找到相关位置。
这里有一个容易误解的细节。
【方法核查补充】我核对了第 6 页 Section 3.3:实际方案从参考重建帧与当前帧估计运动,将运动编码并解码,再用解码后的运动对齐参考特征,之后进行特征细化。
因此:
- 特征域补偿仍然可以依赖运动估计。
- Figure 1 没画运动支路,不代表没有运动码率。
- 解码器使用的条件,必须能由共享模型和已解码信息一致生成。
Section 3.3 尚未计为逐段精读;这里只核查引言概述的准确含义。
本段报告的数字是:针对其 1080p 标准测试视频,相比 x265 veryslow 节省 26.0% 码率,相比 DVCPro 节省 16.4%。目前先记录为作者报告,实验设置与统计方式留到实验部分核验。
三、引言第 4 段:DCVC 的创新定位是什么?
英文短摘录:
“a more comprehensive solution”
翻译:“一种更全面的方案。”
段落释义: 作者承认此前已有工作研究条件编码,将本文的区别定位在条件参与范围与可扩展性,并把更好的条件设计留作开放问题。
这一段对判断创新性非常重要:不能把“首次提出条件编码概念”算作 DCVC 的贡献。
作者强调的是:
- 条件同时进入编码、解码与熵建模。
- 条件可以用可学习的特征表示。
- 条件的定义、生成和使用方式可以继续调整。
作者对先前工作的概括——仅覆盖部分模块,或者需要人工规则筛选内容——仍属于需要核查的文献比较。下一节 Related works 会具体展开。
可扩展性也有明确边界:它说明框架允许改动哪些部分,并不意味着任意替换条件都能改善压缩。
四、四项贡献,分别应该怎样理解?
以下保持论文原列表的顺序,并区分作者主张与后续所需证据。
| 作者的贡献主张 | 阅读时应检查什么 |
|---|---|
| 设计条件编码框架,对条件的定义、使用与学习进行系统设计 | 与残差基线相比,框架改变带来了多少收益? |
| 条件参与三个环节,熵模型提供压缩率与速度的选择 | 各个使用位置是否有效?速度比较怎样进行? |
| 使用特征域条件,帮助恢复高频内容 | 特征维度、消融和重建结果是否支持这一解释? |
| 框架可扩展,条件仍有改进空间 | 哪些部分能替换,已有何种验证? |
第二项还提出:熵模型可以结合空间与时间相关性追求压缩率,也可以仅利用时间相关性追求速度。这里的“仅时间”针对熵模型中的相关性利用方式,不意味着整套网络不处理空间结构,也不能据此认定编解码器已经达到实时运行。
这四项贡献彼此关联:框架概括整体设计,三个使用位置描述实现方式,特征域决定条件的表示,可扩展性描述后续能调整的部分。
Introduction 读完后,应掌握的主线
作者先用残差编码框架提出问题,再通过条件熵说明进一步利用相关性的空间,随后提出:
\text{参考信息} \rightarrow \text{运动对齐的特征上下文} \rightarrow \begin{cases} \text{帮助形成表示}\\ \text{帮助图像重建}\\ \text{帮助概率估计} \end{cases}
其中,改善概率估计与让解码变换直接获得参考特征,是两个不同作用。只把上下文送给熵模型,不会自动让解码变换获得同样的条件输入。
本轮已读完 Figure 1、引言第 3—4 段和四项贡献。下一轮从第 3 页 Section 2 Related works 的图像压缩首段开始。