来源:papers/iVc/DCVC_精读03_正文方法与实验.md · 原始 Markdown
DCVC 精读第 3 部分 相关工作 方法与实验
本部分接续前两轮,按 NeurIPS 2021 正式版第 3 至 12 页的顺序讲完相关工作、方法、实验、讨论和参考文献。正文采用逐段释义、原始公式、图表分析及独立推导,不转载网络获取论文的长段英文,也不把释义标作全文翻译。公式编号属于论文;明确写作“补充”的公式和例子属于教学内容。
Section 2 Related works
第 1 段 图像压缩方法的演进 第 3 页
释义: 作者先回顾压缩自编码器,再梳理因子化先验、超先验、自回归上下文及更复杂分布模型带来的改进,并提到网络结构从早期循环网络向卷积网络发展的趋势。
讲解: 一个学习式压缩系统至少要同时做好两件事:将图像变成适合量化与重建的表示;为量化结果预测准确的概率。更深的变换网络主要改变表示能力,超先验与自回归模型主要改变概率建模能力。DCVC 的编码与解码结构承接前者,Section 3.2 的多种先验承接后者。作者在这一段提到与 JPEG 2000、H.265 或 H.266 帧内编码的比较,均应理解为所引研究各自设置下的结果,不能合并成一个统一、已复验的排名。
第 2 段 视频压缩的参考约束 第 3 页
释义: 作者区分允许引用未来帧的方法与只利用过去参考信息的方法。前者包括插帧式预测与时空自编码器,后者包括 DVC、DVCPro、多参考帧预测、改进光流及运动编码等工作。
讲解: “未来帧”指相对显示顺序的未来,使用它通常会引入缓存和重排序需求。只依赖过去信息,可以避免这类前视依赖,但并不保证计算耗时足够短。DCVC 属于后者。因此“因果参考结构”和“达到实时帧率”必须分开判断。
第 3 段 与已有条件编码工作的关系 第 3 页
释义: 作者把区别定位在条件的表示、参与位置和学习方式,并分别讨论条件熵编码、带隐状态的学习式编码,以及带显式 skip 分支的条件编码。
关键文献核查:
| 本文编号 | 对应工作及核查范围 | 应如何理解与 DCVC 的区别 |
|---|---|---|
| [3,4] | DVC 与 DVCPro,本文定义及基线说明 | 主要沿用运动预测与残差结构;DVCPro 使用更强网络及熵模型 |
| [13,14] | 超先验与联合自回归先验,本文方法及参考条目 | 是 DCVC 直接承接的图像压缩基础,不能算 DCVC 原创 |
| [15] | Conditional Entropy Coding for Efficient Video Compression,核查原始摘要 | 各帧使用图像压缩器,重点学习潜变量之间的条件熵,不做显式帧间变换;支持本文对其设计重点的概括 |
| [16] | Learned Video Compression,核查原始摘要 | 使用可学习状态、广义补偿和联合信号压缩,不能被概括为没有参考特征思想;本文关于其训练难度与解码形式的比较仍属作者判断,未在本次独立重做实验 |
| [12] | Optical Flow and Mode Selection for Learning-based Video Coding,核查原始摘要 | MOFNet 计算并传递光流与逐像素模式,CodecNet 编码相应内容;模式并非由人工逐帧标注 |
| [17] | Conditional Coding for Flexible Learned Video Compression,核查原文 Section 2 | 包含显式 skip 与 CodecNet 分支,并使用解码端 shortcut 特征;DCVC 的条件编码概念并非首次出现 |
【独立分析】本文所谓省去人工设计的内容分解,应理解为省去特定的显式模式划分框架,不能误译成先前工作靠人工画出每帧掩码。[17] 的模式参数本身是网络生成的。比较时还应承认这些前作具有不同目标,如统一 I/P/B 帧或维护隐状态。
本节要掌握: 创新定位是系统性的条件使用与特征上下文设计;条件概率、图像压缩自编码器、超先验、光流等都已有基础。能解释为什么允许未来参考、使用隐状态、使用显式模式分支是不同设计轴,便建立了阅读方法部分所需的坐标。
Section 3 Proposed method
开篇段落依次引出框架、熵模型、上下文学习和训练。这四部分必须串起来:框架决定要重建什么,熵模型决定比特成本,上下文学习决定参考信息怎样获得,训练则协调这些目标。
Section 3.1 The framework of DCVC 第 3 至 5 页
残差结构与公式 1
\hat x_t=f_{\rm dec}\!\left(Q\!\left(f_{\rm enc}(x_t-\tilde x_t)\right)\right)+\tilde x_t, \qquad \tilde x_t=f_{\rm predict}(\hat x_{t-1}).\tag{1}
这里用 Q 代写原文的取整符号。编码器处理残差,解码器恢复残差,再加回预测。hat 表示重建值,tilde 表示预测值;预测信息来自重建参考帧,便于双方一致获得。本文对预测函数的讨论同时涵盖传统运动工具与神经运动估计、补偿实现。
RGB 条件与公式 2
\hat x_t=f_{\rm dec}\!\left(Q(f_{\rm enc}(x_t\mid\tilde x_t))\mid\tilde x_t\right), \qquad\tilde x_t=f_{\rm predict}(\hat x_{t-1}).\tag{2}
竖线在这里表示网络接收条件,不是求条件概率的算子,也不是把 x 除以预测帧。与公式 1 相比,网络直接接收当前帧和条件,没有预先规定的外部残差减加操作。实际实现采用通道拼接。
特征条件与公式 3
\hat x_t=f_{\rm dec}\!\left(Q(f_{\rm enc}(x_t\mid\bar x_t))\mid\bar x_t\right), \qquad \bar x_t=f_{\rm context}(\hat x_{t-1}).\tag{3}
作者进一步把 RGB 预测改为学习到的上下文。公式右侧是简写,运动信息的依赖在公式 6 和 Figure 2 中展开,不能据这个简写断言条件只由参考图像单独生成。
Figure 2 完整框架
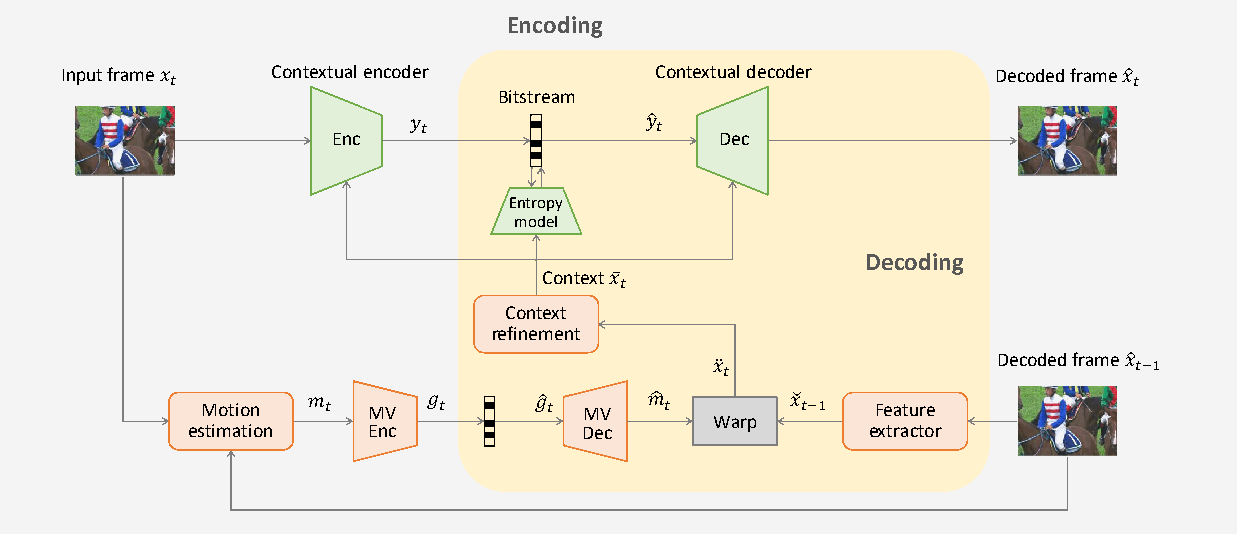
从输入到输出逐步看:
- 运动估计使用当前帧 x_t 与参考重建帧 x_hat_{t-1},获得运动 m_t。
- MV Enc 形成运动潜变量 g_t,量化与编码后,在双方恢复 g_hat_t,再经 MV Dec 得到 m_hat_t。
- 对参考重建帧提取特征,利用 m_hat_t 对齐,再经上下文细化获得 x_bar_t。
- 当前帧与上下文共同经过 contextual encoder,生成 y_t;量化并熵编码后得到可传输表示。
- 解码端利用已解码运动、参考重建帧及相关先验恢复相同上下文和 y_hat_t,经过 contextual decoder 重建 x_hat_t。
- x_hat_t 成为下一时刻的参考。模型不要求解码器访问原始 x_t。
图中浅黄色区域强调解码所需部分,绿色模块对应图像内容编码与解码,橙色模块涉及运动和上下文生成。它是比 Figure 1 更具体的系统图;超先验码流还需结合 Figure 4 及补充材料理解。图中上下文直接送入熵模型,不能漏掉这一条作用。
Figure 3 特征和误差可视化 第 4 至 5 页
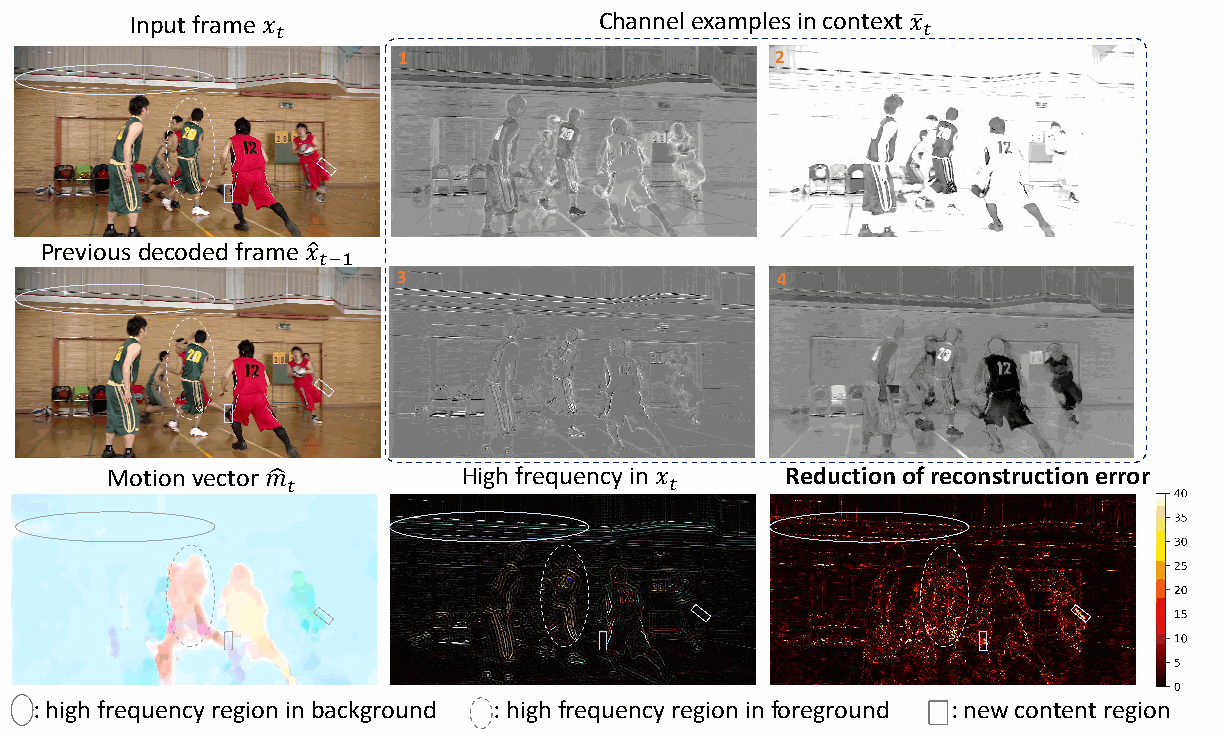
正文先讨论特征通道分工,再用跨页段落讨论新出现内容,最后引出熵模型。图中左侧为当前帧、参考重建帧和运动;右上为四个上下文通道;右下为 DCT 提取的高频图及相对 DVCPro 的重建误差下降图。椭圆、虚线轮廓和矩形分别标示背景高频、前景高频和新出现区域。
【作者解释】部分通道看起来更关注高频,部分更关注颜色;高维特征帮助复杂纹理和新内容的重建。图例来自 MCL-JCV 的 videoSRC05,DCVC 为 0.0306 BPP,DVCPro 为 0.0359 BPP。
【独立分析】这是支持机制直觉的个例,不证明所有通道都具有稳定且唯一的语义,也不单独证明提升来自通道维度而非其他模块。遇到显露背景等没有良好参考的新内容时,条件网络可以减弱对参考的依赖;这是一种隐式适应能力,图中没有另画一个硬性的帧内/帧间开关,不能说模型必然学出了某种固定模式。
本节要掌握: 公式 1 改成 2,改变的是使用条件的方式;2 改成 3,改变的是条件的表示。Figure 2 保证这些改动仍能构成可解码系统。最后的过渡段说明,同一上下文还用于压缩 y_hat_t,进入下一节。
Section 3.2 Entropy model 第 5 至 6 页
公式 4 与交叉熵
R(\hat y_t)\geq\mathbb E_{\hat y_t\sim q_{\hat y_t}} [-\log_2p_{\hat y_t}(\hat y_t)].\tag{4}
q 是真实的量化潜变量分布,p 是学习到的概率模型。论文把右侧作为使用该模型进行实际编码时的紧致码率估计,并说明算术编码可以接近它。该关系应放在既定熵模型和编码方案下理解,不应误当作任意 p 都给所有可能编码器提供同一个通用下界。
补充推导:
H(q,p)=-\sum_uq(u)\log_2p(u) =H(q)+D_{\rm KL}(q\Vert p).
推导时在对数中乘除 q(u):-log p(u)=-log q(u)+log(q(u)/p(u)),分别求和,便得到上式。KL 项非负,所以在真实表示分布固定时,更准确的 p 有机会减少模型失配造成的冗余。真实文件还包含有限精度、终止和封装开销;训练率估计不等于字节数的严格逐项复刻。
Figure 4 三种先验
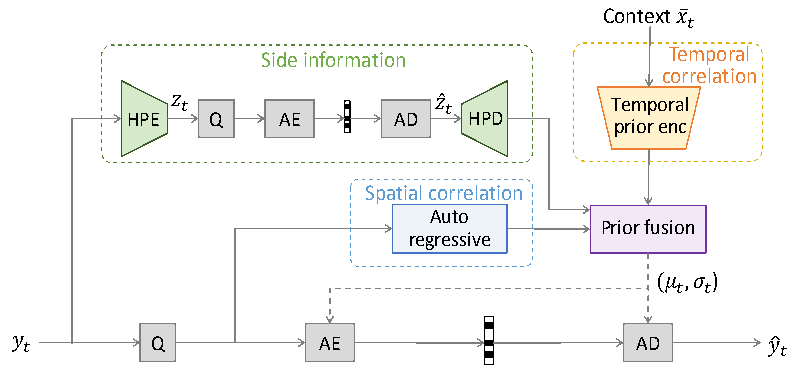
| 来源 | 在解码时何时可用 | 是否形成单独传输的潜变量 |
|---|---|---|
| 超先验 f_hpd(z_hat_t) | 先解码 z_hat_t,再用超先验解码器生成参数 | z_hat_t 需要比特 |
| 空间先验 f_ar(y_hat_{t,<i}) | 当前位置之前的符号已解码后 | 不另传一份空间特征,但引入顺序依赖 |
| 时间先验 f_tpe(x_bar_t) | 已解码运动及参考重建帧生成上下文后 | 不另传一份时间特征;依赖已有参考和运动信息 |
HPE/HPD 是超先验编码器/解码器,Q 是量化,AE/AD 是算术编码器/解码器。绿色支路传送侧信息,蓝色支路从已解码符号获取空间上下文,橙色支路从参考上下文获取时间信息。融合网络输出概率分布参数,而非直接输出图像像素。
公式 5 的完整含义
p_{\hat y_t}(\hat y_t\mid\bar x_t,\hat z_t) =\prod_i\left[\mathcal L(\mu_{t,i},\sigma_{t,i}^{2}) *\mathcal U(-\tfrac12,\tfrac12)\right](\hat y_{t,i}),\tag{5}
(\mu_{t,i},\sigma_{t,i})= f_{\rm pf}\!\left(f_{\rm hpd}(\hat z_t), f_{\rm ar}(\hat y_{t,<i}),f_{\rm tpe}(\bar x_t)\right).
mu 是位置参数,sigma 是论文文字所称的尺度参数;pf 为先验融合,hpd 为超先验解码,ar 为自回归,tpe 为时间先验编码。论文把 i 描述为空间位置;实现需要进一步覆盖相应位置上的通道符号。乘积按解码顺序展开,不意味着所有符号无条件独立,因为 mu、sigma 依赖此前已解码符号。
补充说明: 更明确的条件概率形式是乘积 p(y_hat_i given y_hat_<i, z_hat, context)。这揭示空间先验为什么不能在真正解码时全部同时算出。编码时知道所有符号,不等于解码时也知道。
为什么与均匀分布卷积? 量化符号的概率是一个宽度为 1 的量化区间内的概率质量,不是连续密度在某点的数值。为避免原文 sigma 平方记号与尺度约定混淆,以下另用 b>0 表示 Laplace 尺度:
f(u)=\frac1{2b}e^{-|u-\mu|/b},\qquad p(\hat y=k)=\int_{k-1/2}^{k+1/2}f(u)\,du =F(k+1/2)-F(k-1/2).
均匀密度在 [-1/2,1/2] 上为 1,因此卷积在 k 处的值恰好等于这个积分。若 mu=0、b=1、k=0,得到 1-exp(-0.5),约 0.39347;不能误用密度 f(0)=0.5 作为该符号概率。
实现核查: 官方 2021 子目录的 DCVC_net.py 在 feature_probs_based_sigma 中构造 Laplace(mu,sigma),并使用 CDF 差计算区间概率。因此实现中的 sigma 直接作为尺度,不应看到公式的 sigma 平方就机械地在实现中再平方。
去掉空间先验的版本
正文最后一段删去自回归输入,使分布参数仅由超先验和时间先验生成:
(\mu_{t,i},\sigma_{t,i})=f_{\rm pf} \left(f_{\rm hpd}(\hat z_t),f_{\rm tpe}(\bar x_t)\right).
它消除了图像潜变量空间自回归造成的这类位置依赖,但保留超先验,也不能直接推断运动支路和整个文件编解码已完全并行。对压缩率的损失见 Table 3;正文没有给出这一变体完整的实际编解码速度表。
本节要掌握: 区分离散概率质量与连续密度;区分超先验、空间先验和时间先验的来源、比特开销与解码顺序;解释概率更准如何通过交叉熵降低码率。
Section 3.3 Context learning 第 6 页
第一段指出,直接对上一重建帧应用普通卷积,可能难以在复杂运动下找到当前位置真正相关的信息,因此引入特征域运动补偿。所谓难以学习,是作者对其设计动机的解释,不应说成普通网络理论上不可能处理运动。
\bar x_t=f_{\rm cr}\!\left( \operatorname{warp}(f_{\rm fe}(\hat x_{t-1}),\hat m_t) \right).\tag{6}
第二段给出操作顺序:fe 从参考重建帧提取特征;光流网络由参考重建帧与当前帧估计运动;运动编码再解码;warp 按解码后的运动采样参考特征;cr 细化对齐结果,缓解采样造成的不连续。
补充数值直觉: 若某一维参考特征在两个相邻采样点为 10 和 14,采样位置位于二者之间的 0.25 处,线性插值得到 0.75×10+0.25×14=11。二维双线性采样相应组合四个相邻点。具体流方向、边界处理和坐标归一化必须遵循实现,不能仅凭“右移几格”的口述确定代码符号。
解码端没有原始当前帧,却有解码后的运动和同一重建参考帧,因而能计算相同的上下文。运动通过压缩引入的误差也会进入后续率失真权衡。
Section 3.4 Training 第 7 页
L=\lambda D+R.\tag{7}
第一段用 lambda 协调失真与码率。lambda 越大,同样一点失真下降带来的目标改善越大,通常会选择更高质量、更高码率的工作点;但实际结果要由训练得到。MSE 应越小越好,MS-SSIM 原值则越大越好:当其用于最小化失真时,需要合适的失真形式,不能直接把原始 MS-SSIM 当成越小越好。该正文段落没有展开具体转换公式。
第二段列出学习率初始 1e-4、微调 1e-5、batch size 4。MSE 模型对应 lambda=256、512、1024、2048;MS-SSIM 模型对应 8、16、32、64。是分别训练四个工作点,不应理解为单模型已支持连续码率控制。
【补充材料澄清】R 含图像潜变量、运动潜变量及二者各自的超先验,共四项;不能只数 y_hat。完整渐进训练将在补充材料部分解释。正文与补充材料未在这些段落完整列出每阶段轮数、随机种子、量化梯度处理等细节,复现时不应自行填写后称其为论文配置。
Section 4.1 Experimental settings 第 7 页
按四个设置单元阅读:训练集为 Vimeo-90k septuplet 的训练部分,随机裁成 256×256;测试覆盖 MCL-JCV、UVG 与 HEVC Class B/C/D/E;GOP 在 HEVC 上为 10,其余为 12;对照包括 DVC、DVCPro、x264 与 x265。
I 帧使用现成图像压缩模型,MSE 目标为 cheng2020-anchor,MS-SSIM 目标为 hyperprior。DVC 与 DVCPro 使用相同 I 帧编码重新测试,这是控制系统级比较混杂因素的重要安排。x264/x265 用 veryslow 和固定 QP,区别于既有配置的 veryfast 与 CRF。补充材料进一步给出帧数、参数和质量档位。
补充指标知识: BPP=比特数/(图像高×宽),用于整段视频时需对应累计像素数;PSNR=10log10(MAX²/MSE),越高越好;MS-SSIM 越高通常表示该结构相似性指标越好。不同模型为不同目标训练,不能混合其 PSNR 与 MS-SSIM 结果建立统一排名。
Section 4.2 Performance comparison 第 7 至 8 页
Figures 5 和 6 率失真曲线
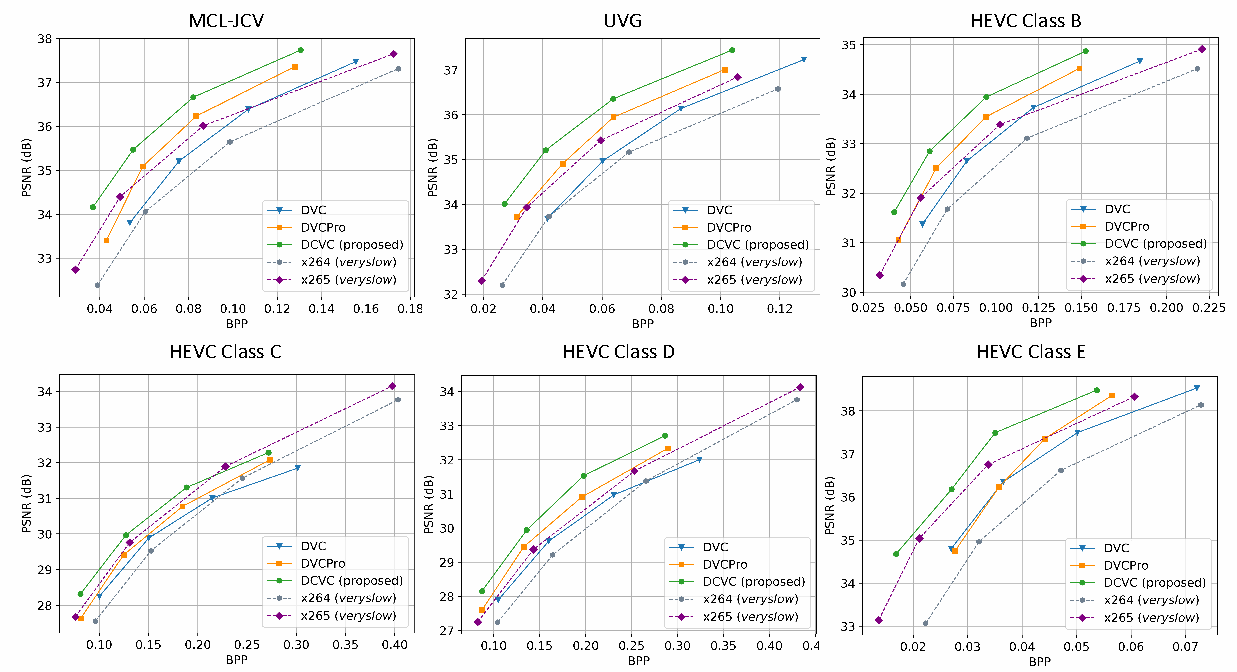
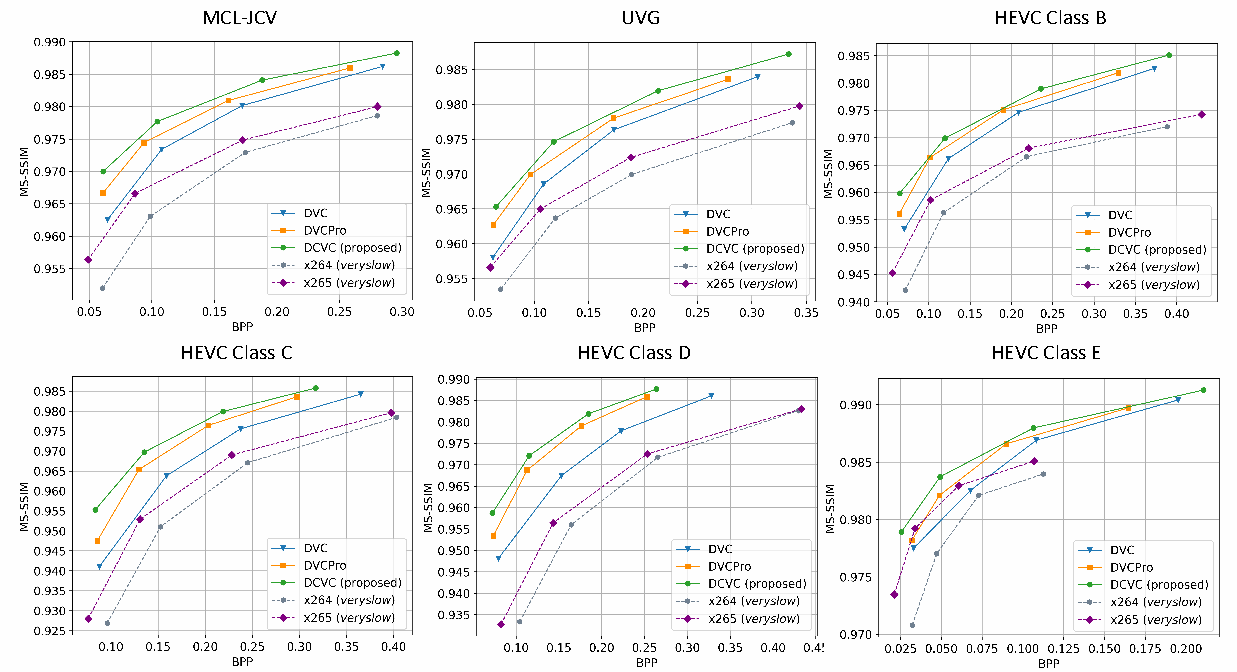
横轴 BPP,纵轴分别为 PSNR 和 MS-SSIM。各子图对应六个测试集合,比较 DVC、DVCPro、DCVC 和两种传统基线;总体更靠左上方表示更有利的率失真取舍。Figure 6 的神经模型经过 MS-SSIM 微调。作者关于优势覆盖码率范围的判断,应限制在图中已测试且有可比质量区间的工作点,不能延伸到未测码率。
Table 1 原表与数值
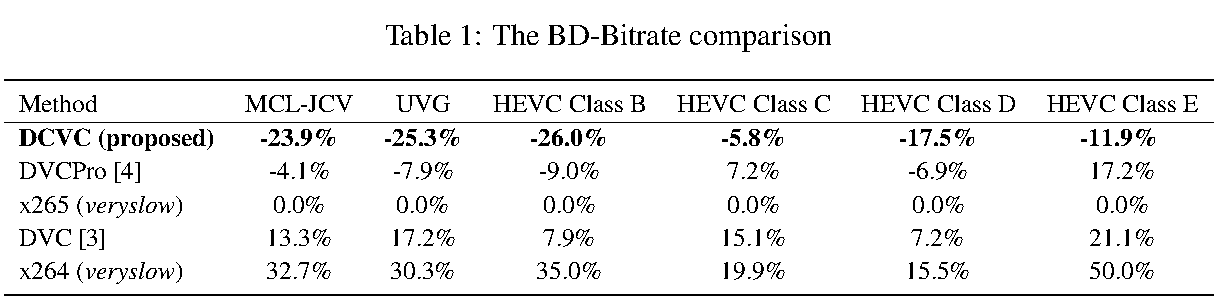
下表照录数值,均以 x265 veryslow 为锚点,指标是基于 PSNR 曲线的 BD-Bitrate:
| 方法 | MCL-JCV | UVG | HEVC B | HEVC C | HEVC D | HEVC E |
|---|---|---|---|---|---|---|
| DCVC | -23.9% | -25.3% | -26.0% | -5.8% | -17.5% | -11.9% |
| DVCPro | -4.1% | -7.9% | -9.0% | +7.2% | -6.9% | +17.2% |
| x265 veryslow | 0.0% | 0.0% | 0.0% | 0.0% | 0.0% | 0.0% |
| DVC | +13.3% | +17.2% | +7.9% | +15.1% | +7.2% | +21.1% |
| x264 veryslow | +32.7% | +30.3% | +35.0% | +19.9% | +15.5% | +50.0% |
负值表示达到可比质量时平均码率更低。摘要的 26.0% 对应 HEVC Class B,不是三个 1080p 集合共用的固定数值。
BD-Rate 补充推导: 在共同质量区间 [d1,d2] 上,用曲线插值得到 log R_A(d) 与 log R_B(d),计算其差的区间平均 Delta,再计算 exp(Delta)-1,若用 log10 则对应 10^Delta-1。它比较的是质量区间内的平均相对码率,不是某一帧文件大小。不同锚点的 BD-Rate 不能简单相减;积分区间不同,也不宜用两个汇总值的比值代替重新计算第三种比较。本文引言报告相对 DVCPro 的 16.4%,不能由 -26.0% 与 -9.0% 的直接相减验证。
后续正文将高分辨率上的较大提升归因于丰富纹理与高维上下文。【独立分析】这是与可视化相符的解释,但分辨率、内容、运动等同时变化,尚不能仅凭跨数据集比较证明分辨率是独立因果因素。
Complexity
正文给出 DCVC 为 2268G MAC,DVCPro 为 2014G MAC,约增加 13%;P40 GPU 上每个 1080p 帧报告的推理耗时为 857 ms 与 849 ms,约增加 1%。运算量与耗时不是线性等价,硬件并行度可以影响这一关系。这组数值没有证明实时运行,也不等价于完整系统每个环节均已计时的部署吞吐率。更不能从“时间先验并行”推断整个编解码链条都并行。
Section 4.3 Ablation study 第 8 至 9 页
Table 2 条件方式与时间先验
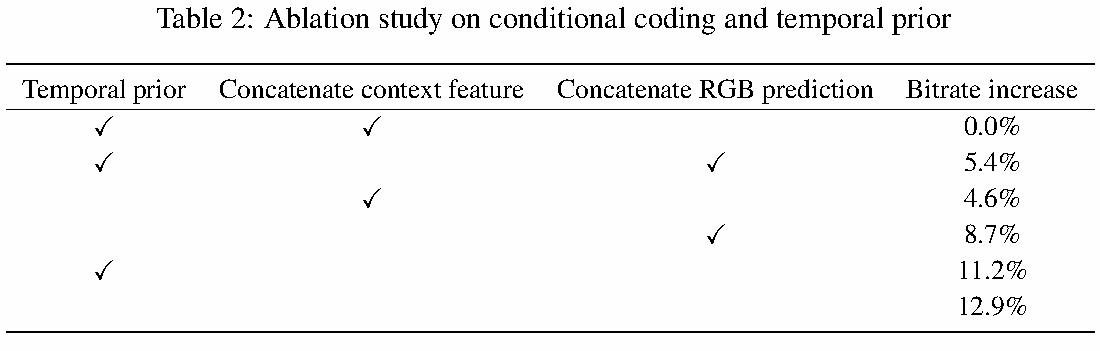
| 时间先验 | 图像编码方式 | 相对最终方案的码率增加 |
|---|---|---|
| 有 | 拼接特征上下文 | 0.0% |
| 有 | 拼接 RGB 预测图 | 5.4% |
| 无 | 拼接特征上下文 | 4.6% |
| 无 | 拼接 RGB 预测图 | 8.7% |
| 有 | 残差编码 | 11.2% |
| 无 | 残差编码 | 12.9% |
这里重新对照原图勾选位置,避免 PDF 文本提取把勾选错配。第一段试图回答两个问题:条件编码是否有益;时间先验是否有益。在同样有时间先验时,特征条件优于 RGB 条件和残差;没有时间先验时,特征条件同样优于其他两种方式。加入时间先验也改善三种编码方式。这支持方法的组件选择,不能据此认定各项百分数可线性相加。
百分比方向必须保留:RGB 条件比最终方案多 5.4% 码率,不等于最终方案比 RGB 条件少 5.4%;反向相对节省约为 1-1/1.054=5.12%。表头未单独交代完整的汇总数据范围,不将它自行标为某一数据集的结果。
Table 3 熵模型
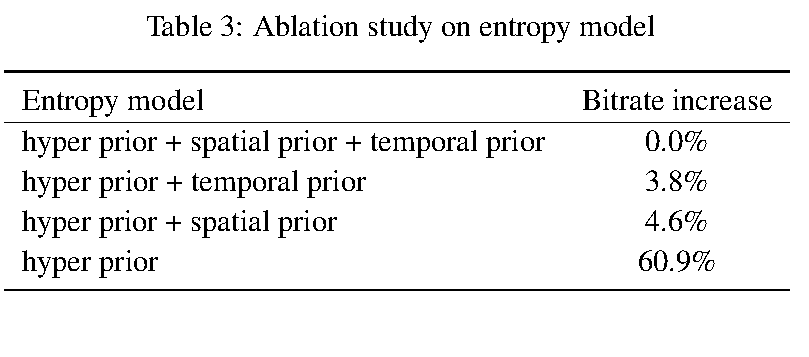
| 图像潜变量的熵模型 | 码率增加 |
|---|---|
| 超先验 + 空间先验 + 时间先验 | 0.0% |
| 超先验 + 时间先验 | 3.8% |
| 超先验 + 空间先验 | 4.6% |
| 仅超先验 | 60.9% |
跨页的第二个实验说明:空间和时间先验各自提供重要帮助,两者共同使用进一步提高压缩率;没有两种上下文时,码率显著上升。去掉空间先验只增加 3.8%,是作者主张进行速度取舍的依据。不能把 60.9% 当作时间先验单独的贡献;它是相对同时使用多种先验的最终方案。该表没有给出重复训练的方差或置信区间,不宜据 3.8% 与 4.6% 的小差别作过强的普遍排序。
Section 4.4 Intra frame coding 与更多基线 第 9 至 10 页
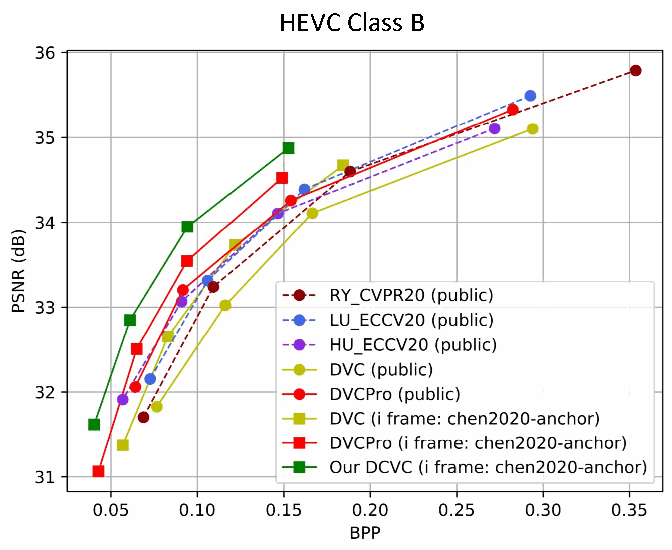
这一跨页段落说明:I 帧编码增强后,DVC 与 DVCPro 都比其公开结果更好;在同一 I 帧设置下 DCVC 仍领先。图中 public 曲线来自既有公开结果,带 I 帧模型名称的曲线为重新测试的配置。加入的 RY_CVPR20、LU_ECCV20、HU_ECCV20 帮助判断当时基线的位置,但不能说这些方法也全部在本文统一配置下重新训练、测试。
本节要掌握: 比较帧间方法,仍须控制 I 帧模型、GOP、帧数、颜色转换与指标计算。系统级改进不应全部归给 P 帧新模块。
Section 5 Discussion 第 10 页
第 1 段: 作者将优势归纳为条件编码在时间与空间信息之间的适应性,以及高维特征对高频内容的帮助,并预计高分辨率下会更有利。【独立分析】适应性与高频解释有实验支持,但不能把理论熵比较扩展为所有残差模型都必然次优;高分辨率趋势也不是对任意内容的保证。
第 2 段: 作者再次指出,条件的定义、使用和学习仍是开放问题。本框架是一个有效实例,不是最优条件的证明。
第 3 段: 作者明确提出三项尚未解决的问题:上下文通道可能冗余、目前只使用单参考帧、未专门考虑重建质量的时间稳定性。多参考帧、通道利用率与时间一致性因此成为后续方向。这里只记录为本文提出的研究接口,不把它们声称为当下尚无人研究的新颖课题。
本文没有另设独立的 Conclusion 或正文附录;Discussion 是正文最后一节,之后为两页参考文献。完整书目与关键关联见 参考文献核查表。
本部分进度
正文从 Section 2 到 Discussion 已按顺序讲完,公式 1 至 7、Figures 2 至 7、Tables 1 至 3 均已检查。正文参考文献 40 项已核对并保留条目信息。下一部分继续补充材料的网络结构、渐进训练、测试细节、长 GOP、消融和视觉比较,最后形成整体评价与最小复现路线。